OpenLLMetryを使ってOpenAI呼び出しをTrace/Metrics/Logsで可視化する (Python + Grafana)





はじめに
N 番煎じではありますが、OpenLLMetry を試してみたので共有です。
ポイントは Trace, Metrics, Log の 3 つとも確認したところです。
事前に自動計装(ゼロコード計装、Auto Instrumentation, Zero-code Instrumentation)を試していたのですが、今回は LLM アプリを SDK を使って明示的に観測してみることにしました。
OpenLLMetry って何?
OpenLLMetry は、LLM アプリの動きを OpenTelemetry のデータ(Trace / Metrics / Logs)として観測できるようにするための計装ツール群です。提供元は Traceloop で、OpenAI / LangChain など主要な LLM ライブラリ向けに、@task / @workflow といった「処理のまとまり」を表現するアノテーションを含む SDK を提供しています。
このメモでは、Python で OpenAI 呼び出しを含むジョブを OpenTelemetry として吐き出し、Grafana(Tempo/Prometheus/Loki など)で確認するまでの最短ルートをまとめます。
参考
OpenLLMetry
何が嬉しい?
- LLM API 呼び出しを「どの処理の中で」「どれくらい時間がかかったか」追える(Trace)
-
ワークフロー全体・タスクごとの分解ができる(
@workflow/@task) -
既存の
loggingをほぼそのまま OpenTelemetry Logs として集約できる(OpenTelemetry の機能) - 対応ライブラリ(例: OpenAI)については 呼び出し自体の計装をかなり自動化できる
注意: 「処理の意味づけ(例: これは llm_job の中の openai_call である)」は、基本的にアプリ側で @task / @workflow などを付けて表現します。
事前準備
収集先(OTel Collector / Grafana)
OTLP(gRPC)で受けられる Collector が立っていれば何でも OK です。ここでは Grafana の LGTM 系(Loki/Grafana/Tempo/Mimir or Prometheus)を docker compose で立ち上げる想定にします(後述の参考リンク)。
コード
Trace / Metrics / Logs を全部送る構成にしています。
冗長な部分もあるかもです。
import logging
import os
import sys

from openai import OpenAI
from opentelemetry.exporter.otlp.proto.grpc._log_exporter import OTLPLogExporter
from opentelemetry.exporter.otlp.proto.grpc.metric_exporter import OTLPMetricExporter
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
from traceloop.sdk import Traceloop
from traceloop.sdk.decorators import task, workflow
from traceloop.sdk.instruments import Instruments


def _require_env(name: str) -> str:
    value = os.getenv(name)
    if value:
        return value
    print(f"Missing required env var: {name}", file=sys.stderr)
    sys.exit(2)


def _normalize_otlp_grpc_endpoint(endpoint: str) -> str:
    if endpoint.startswith("http://"):
        return endpoint.removeprefix("http://")
    if endpoint.startswith("https://"):
        return endpoint.removeprefix("https://")
    return endpoint


def init_traceloop() -> None:
    service_name = os.getenv("OTEL_SERVICE_NAME", "llm-job")
    otlp_endpoint = _normalize_otlp_grpc_endpoint(
        os.getenv("OTEL_EXPORTER_OTLP_ENDPOINT", "http://collector:4317")
    )
    deployment_env = os.getenv("DEPLOYMENT_ENVIRONMENT", "development")

    span_exporter = OTLPSpanExporter(endpoint=otlp_endpoint, insecure=True)
    metric_exporter = OTLPMetricExporter(endpoint=otlp_endpoint, insecure=True)
    log_exporter = OTLPLogExporter(endpoint=otlp_endpoint, insecure=True)

    Traceloop.init(
        app_name=service_name,
        exporter=span_exporter,
        metrics_exporter=metric_exporter,
        logging_exporter=log_exporter,
        # job なので短時間で終了する。バッチだと終了時に送信しきれないことがあるため即時送信に寄せる。
        disable_batch=True,
        # Collector/LGTM側で探しやすいように最低限だけ付与
        resource_attributes={
            "service.name": service_name,
            "deployment.environment": deployment_env,
        },
        instruments={Instruments.OPENAI},
    )


@task(name="openai_call")
def call_openai(model: str, prompt: str) -> str:
    client = OpenAI(api_key=_require_env("OPENAI_API_KEY"))
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content or ""


@workflow(name="llm_job")
def run_workflow(model: str, prompt: str) -> str:
    text = call_openai(model=model, prompt=prompt)
    return text


def main() -> int:
    init_traceloop()

    logging.basicConfig(level=logging.INFO)

    model = os.getenv("OPENAI_MODEL", "gpt-4o-mini")
    prompt = os.getenv("OPENAI_PROMPT", "俳句を詠んで OpenTelemetryについて")

    logger = logging.getLogger("llm-job")
    logger.info("Starting LLM job", extra={"openai.model": model})

    text = run_workflow(model=model, prompt=prompt)
    logger.info("LLM job completed", extra={"output.preview": text[:200]})
    print(text)
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
以下に完全版を置いてます。
実行方法
例(ローカルに Collector がいて localhost:4317 で OTLP gRPC を受ける場合):
export OPENAI_API_KEY='...'
export OTEL_SERVICE_NAME='llm-job'
export DEPLOYMENT_ENVIRONMENT='development'
export OTEL_EXPORTER_OTLP_ENDPOINT='http://localhost:4317'

export OPENAI_MODEL='gpt-4o-mini'
export OPENAI_PROMPT='俳句を詠んで OpenTelemetryについて'

python job.py
ポイント:
-
OTEL_EXPORTER_OTLP_ENDPOINTをhttp://...で渡しても、コード側で gRPC exporter が期待するhost:port形式に寄せています。 -
logger.info(..., extra={...})のextraはログの属性(structured fields)として載せられるので、後で絞り込みに使えます。
参考
workflow/ task
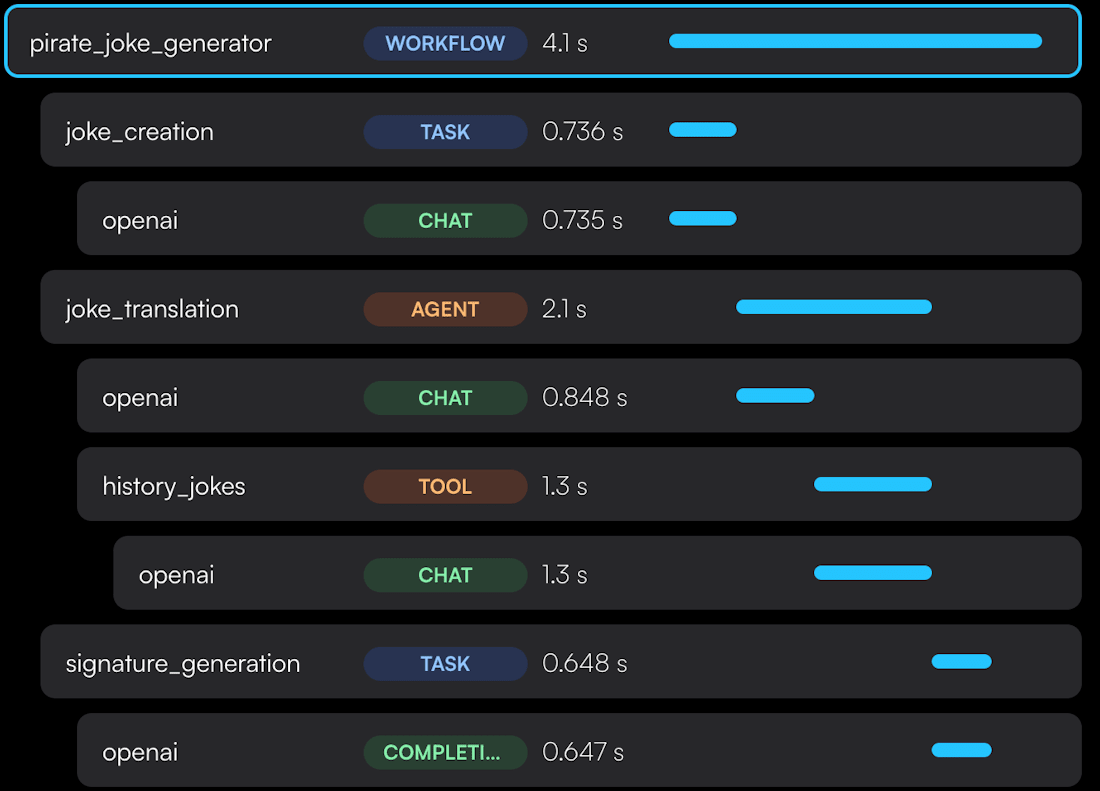
workflow の中に task、その中に chat が入っているようです。
何が取れたか
以下のようにデータが取得できることを確認できました。
traces

metrics

logs

Grafana(docker compose の準備)
手元で LGTM を立てる手順は以下を参照してください。
この記事では詳細は割愛させていただきます。
おわりに
期待通り動いてよかったです。現在、プロンプトや結果も残るようにしているので、必要に応じて無効にしたほうが良いと思います。必要に応じて OTel Collector でマスク処理を実施したり、ハッシュ化すると、よりセキュアになると思います。
Discussion